實測畫面
語料是彩色 ANSI-SGR 混合中文、韓文與 ASCII,由基準腳本寫入工作階段 TTY,無需觸碰手機。
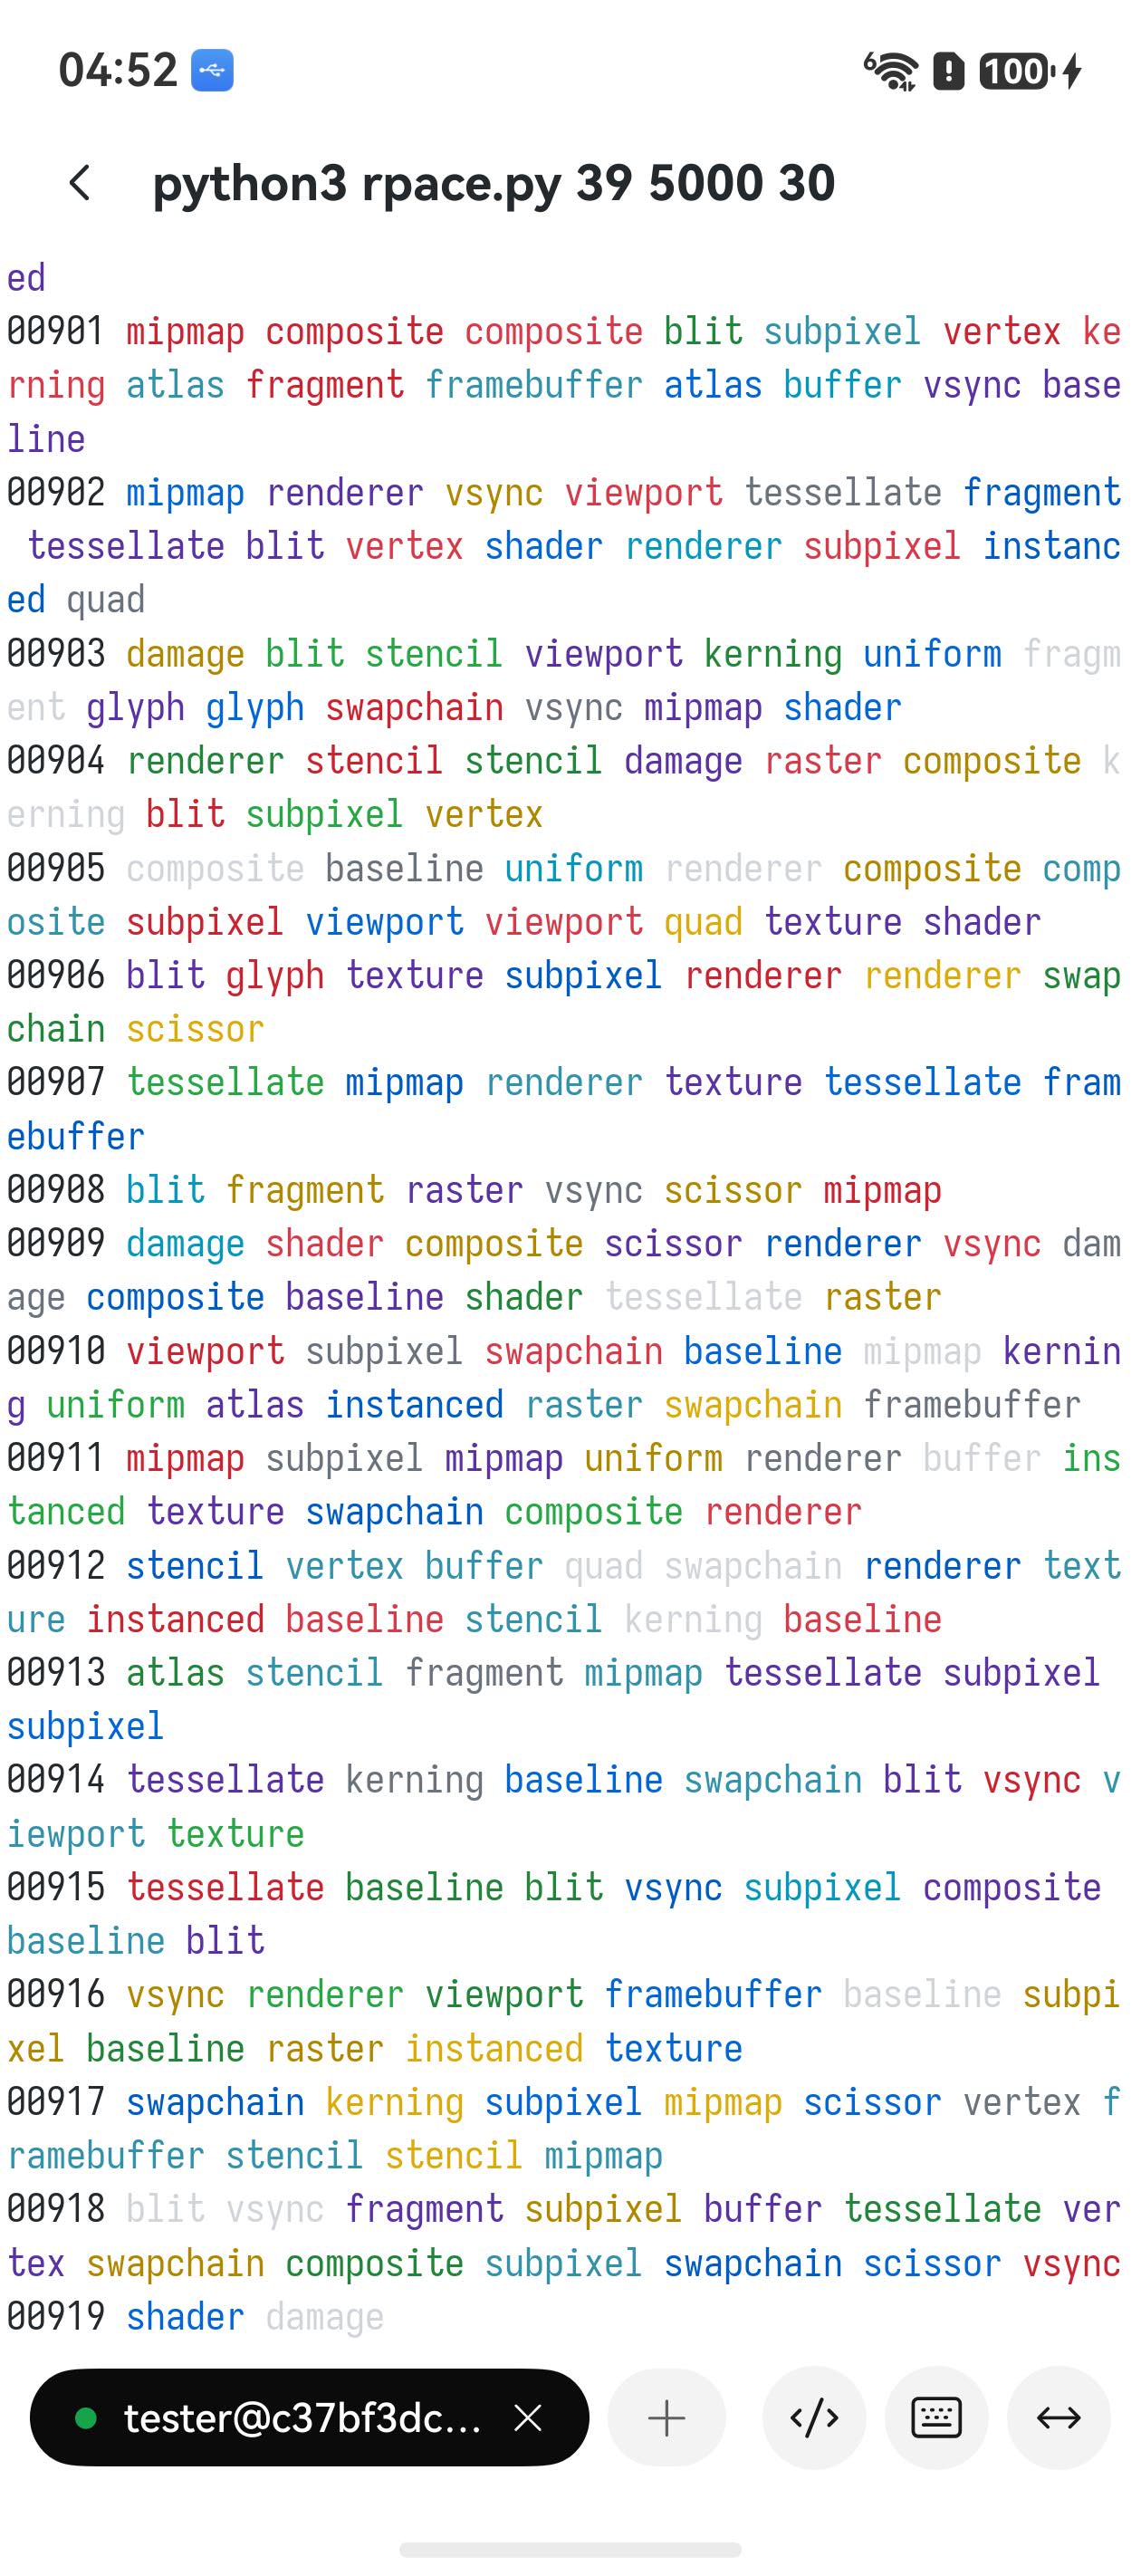
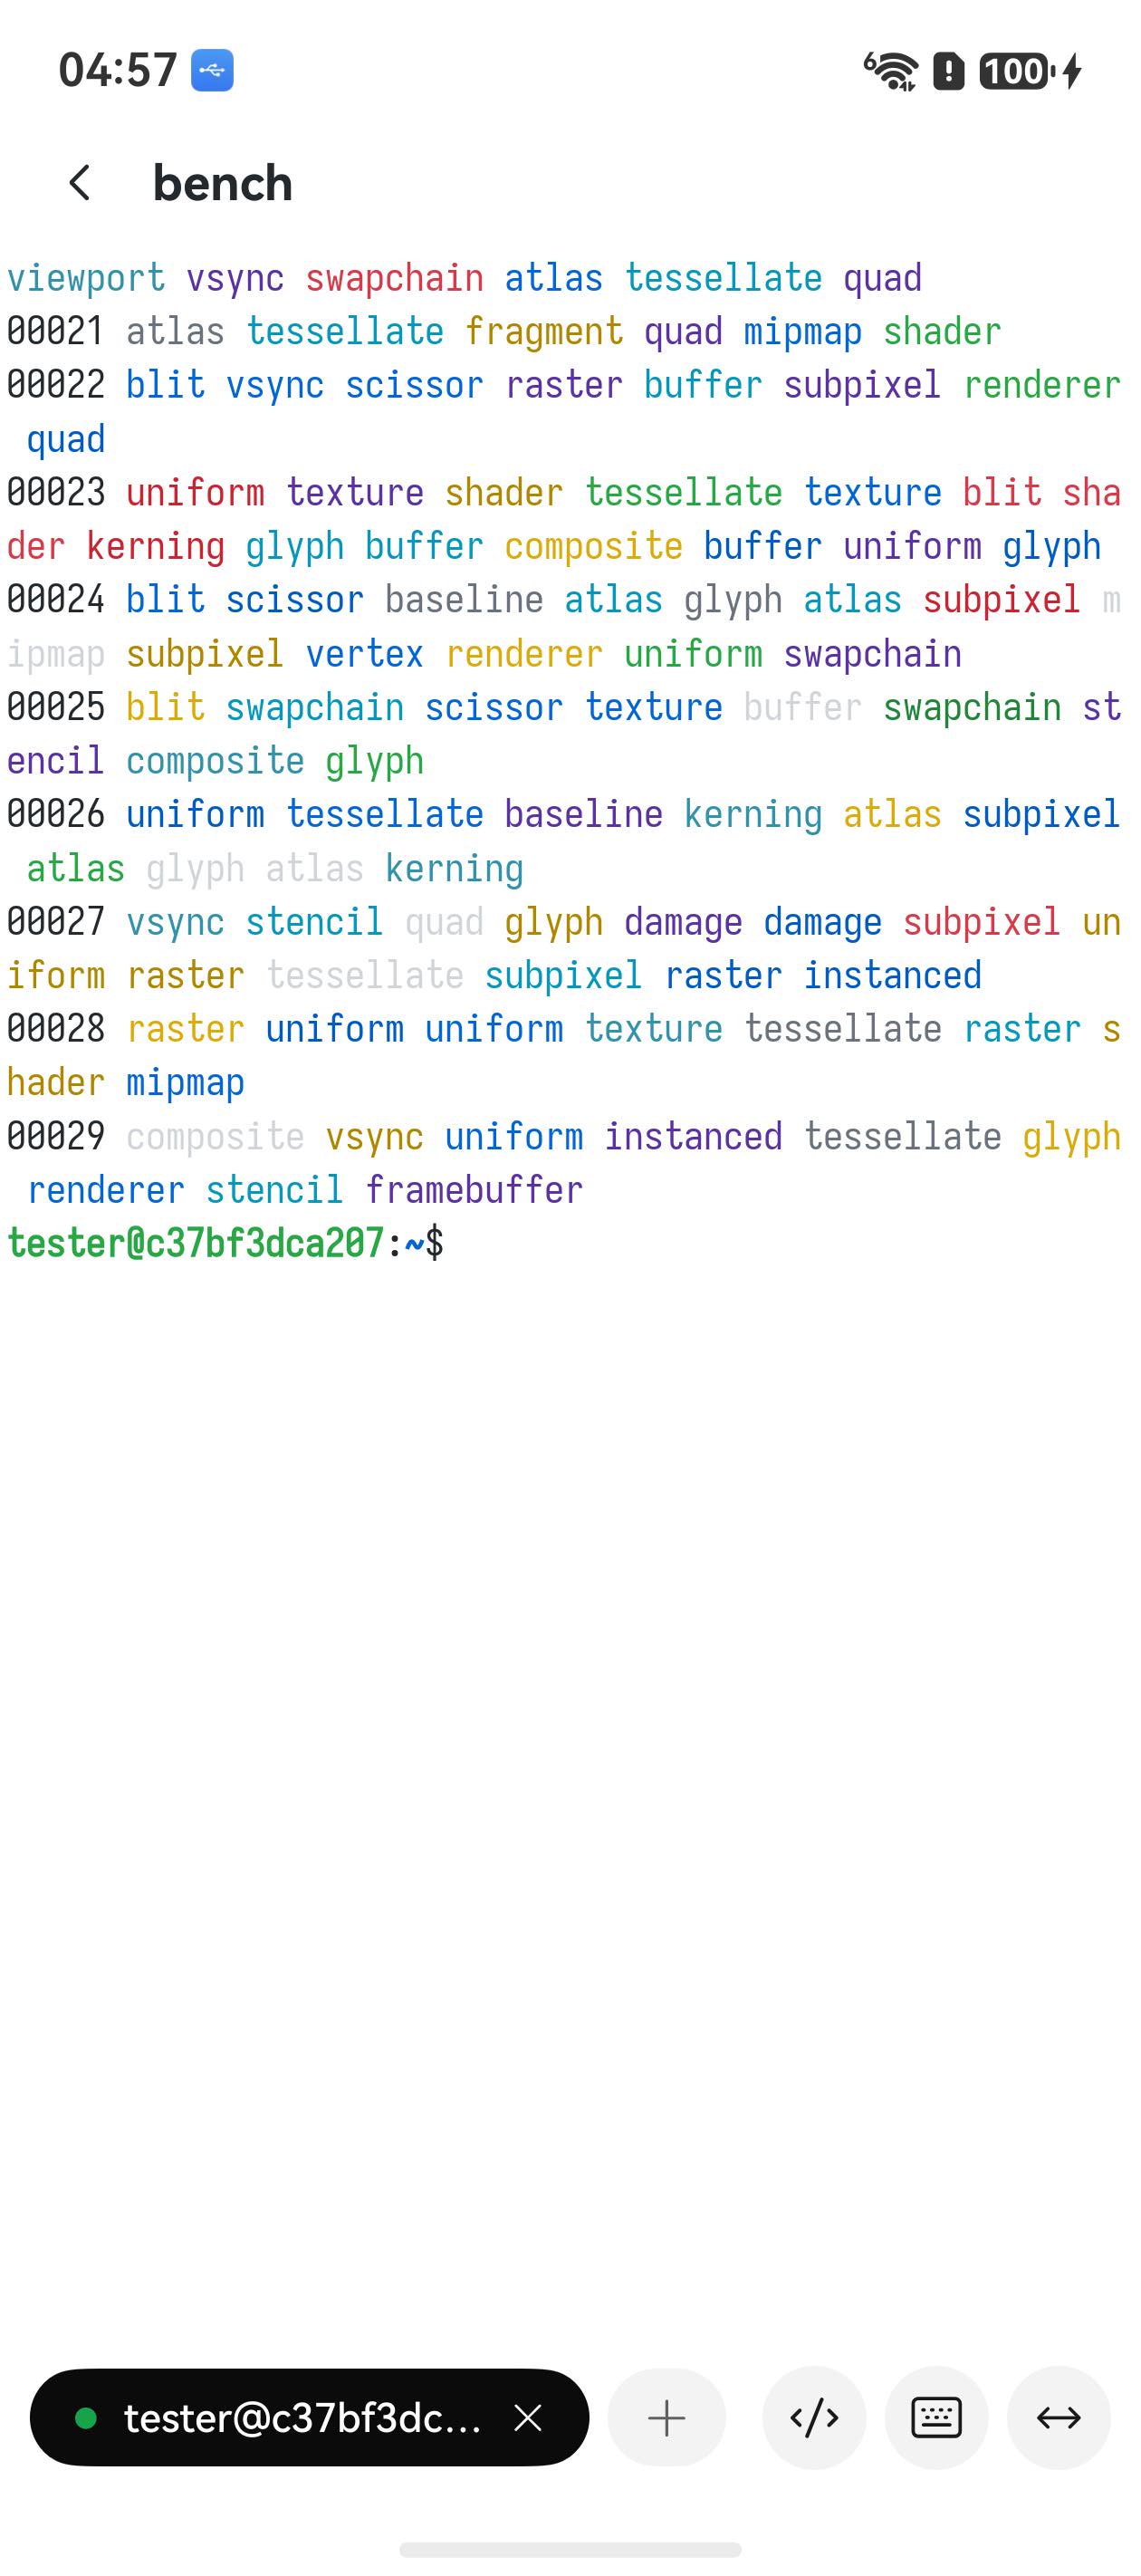
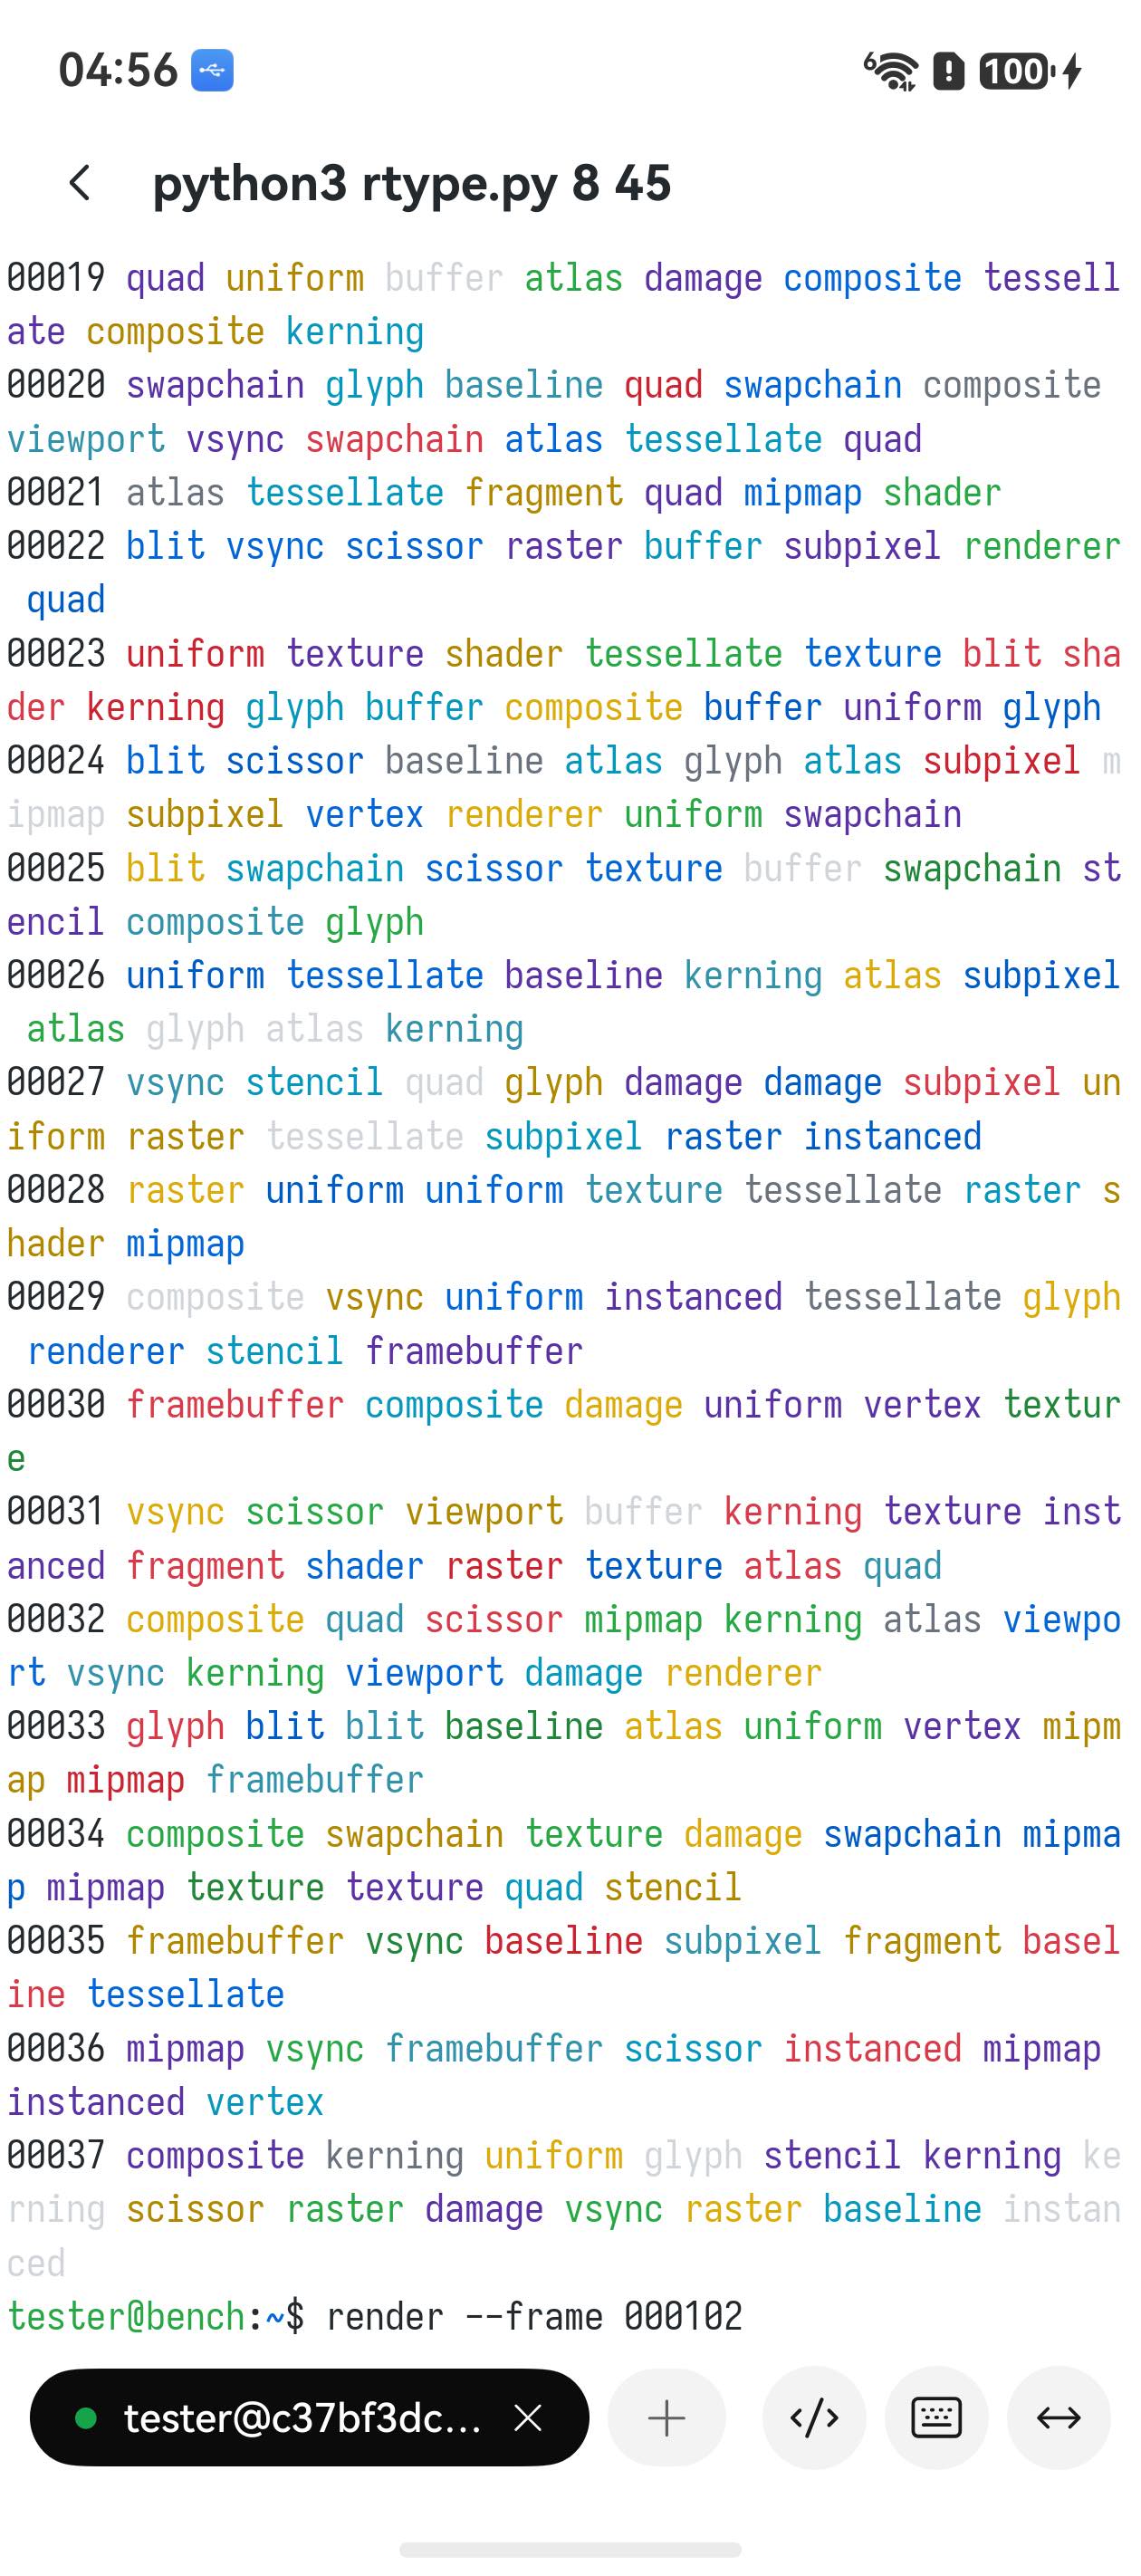
Term 的終端機渲染改用 EGL/GLES3 實例化渲染器:在實機上實測的方法、數據與畫面。
撰寫於 · 更新於
兩次實測、同一份語料,都透過內建的 Log frame stats 開發者開關收集。CPU 那一欄是 2026-07 在 Pura 70 上的基線——CPU 路徑已經刪除,無法重測,因此保留原值;GPU 那一欄是 2026-08 在 HBN-AL80 上的新實測。兩台不同的手機,所以提速倍數只說明量級,不必細究到小數點後兩位。
| 工作負載 | CPU 路徑 | GPU 路徑 | 提速 |
|---|---|---|---|
| 全螢幕捲動(firehose) | 14.6 ms · 68 fps | 4.26 ms · 235 fps | 3.4× |
| 慢速捲動(~5 行/幀) | 12.8 ms · 76 fps | 5.05 ms · 198 fps | 2.5× |
GPU 路徑的幀時間幾乎與捲動量無關:每一幀都是一次完整重繪,而這對 GPU 來說很便宜。CPU 路徑對捲動行數敏感的問題就此消失。
每幀約 1400 個實例化四邊形。字形只光柵化一次進入紋理圖集,之後每幀僅重新發射網格實例。
| 階段 | 平均 | 說明 |
|---|---|---|
| build | 1.82 ms | CPU 側:遍歷網格 → 實例四邊形 + 光柵化新字形入圖集 + 上傳 |
| draw | 0.35 ms | GL 實例化繪製 |
| swap | 2.08 ms | eglSwapBuffers(呈現) |
| 幀總計 | 4.26 ms | ≈ 235 fps |
消除兩次搬運 14 MB 的記憶體操作:不再有影子位圖的捲動位移(~6 ms),也不再有到 dmabuf 的複製(~5.6 ms),這 ~11 ms 就是全部的節省。GPU 直接在 EGL 表面上原地光柵化。
語料是彩色 ANSI-SGR 混合中文、韓文與 ASCII,由基準腳本寫入工作階段 TTY,無需觸碰手機。
腳本自動化三個階段(firehose 捲動/閒置閃爍/單行更新),透過向遠端主機上工作階段的 TTY 寫入實現:手機端零互動。
#!/bin/bash
T="${1:-/dev/ttys000}"

# 語料:彩色 ANSI-SGR + 中文/韓文/ASCII,400 行
corpus() {
  i=0
  while [ $i -lt 400 ]; do
    printf "\033[3%dm%04d 端末描画性能測定 中文渲染基准 가나다라마 \033[1mBOLD\033[0m ascii-abcdefghijklmnop %05d\n" \
      $((i % 8)) $i $((i * 37))
    i=$((i + 1))
  done
}
C="$(corpus)"

# P1 firehose 捲動 30s(滿幀全損)
printf "\n\033[36m=== GPUBENCH P1: firehose scroll 30s ===\033[0m\n" > "$T"
end=$((SECONDS + 30))
while [ $SECONDS -lt $end ]; do printf "%s\n" "$C" > "$T"; done

# P2 閒置 60s(僅閃爍 → 局部呈現幀)
printf "\n\033[36m=== GPUBENCH P2: idle (blink only) 60s ===\033[0m\n" > "$T"
sleep 60

# P3 單行更新 20s(~8 Hz,輸入形狀的局部幀)
printf "\n\033[36m=== GPUBENCH P3: single-row updates 20s ===\033[0m\n" > "$T"
end=$((SECONDS + 20))
n=0
while [ $SECONDS -lt $end ]; do
  printf "\rtyping simulation %06d" $n > "$T"
  n=$((n + 1))
  sleep 0.12
done
printf "\n\033[36m=== GPUBENCH done ===\033[0m\n" > "$T"
gpubench.sh 複製到該主機,用 who -u 找到工作階段對應的 TTY。./gpubench.sh /dev/ttysNNN(工作階段的 tty)。hdc -t <target> shell hilog | grep "connrender: gpu",每 60 幀輸出一條統計視窗。有兩件事決定一次實測有沒有意義。要給資料流限速。直接 cat 並不是持續負載——這裡 20 萬行 / 28 MB 不到一秒就消費完了,之後每個統計視窗都只是游標閃爍的 2 fps;把那些視窗讀成「渲染器只有 2 fps」,等於什麼都沒測到。要按一個已知的速率持續供數。要盯著頻率。同一畫面內容,每秒只畫兩次時約 11 ms/幀,持續負載下約 4.3 ms——2.5 倍的差距純粹來自 DVFS。停頓後的第一幀該用 11 ms 這個數,持續負載該用 4.3 ms,兩者不可混比。另外記得收起軟鍵盤:鍵盤一彈,網格就從 56×39 縮到 56×19,所有數字都會變好看。